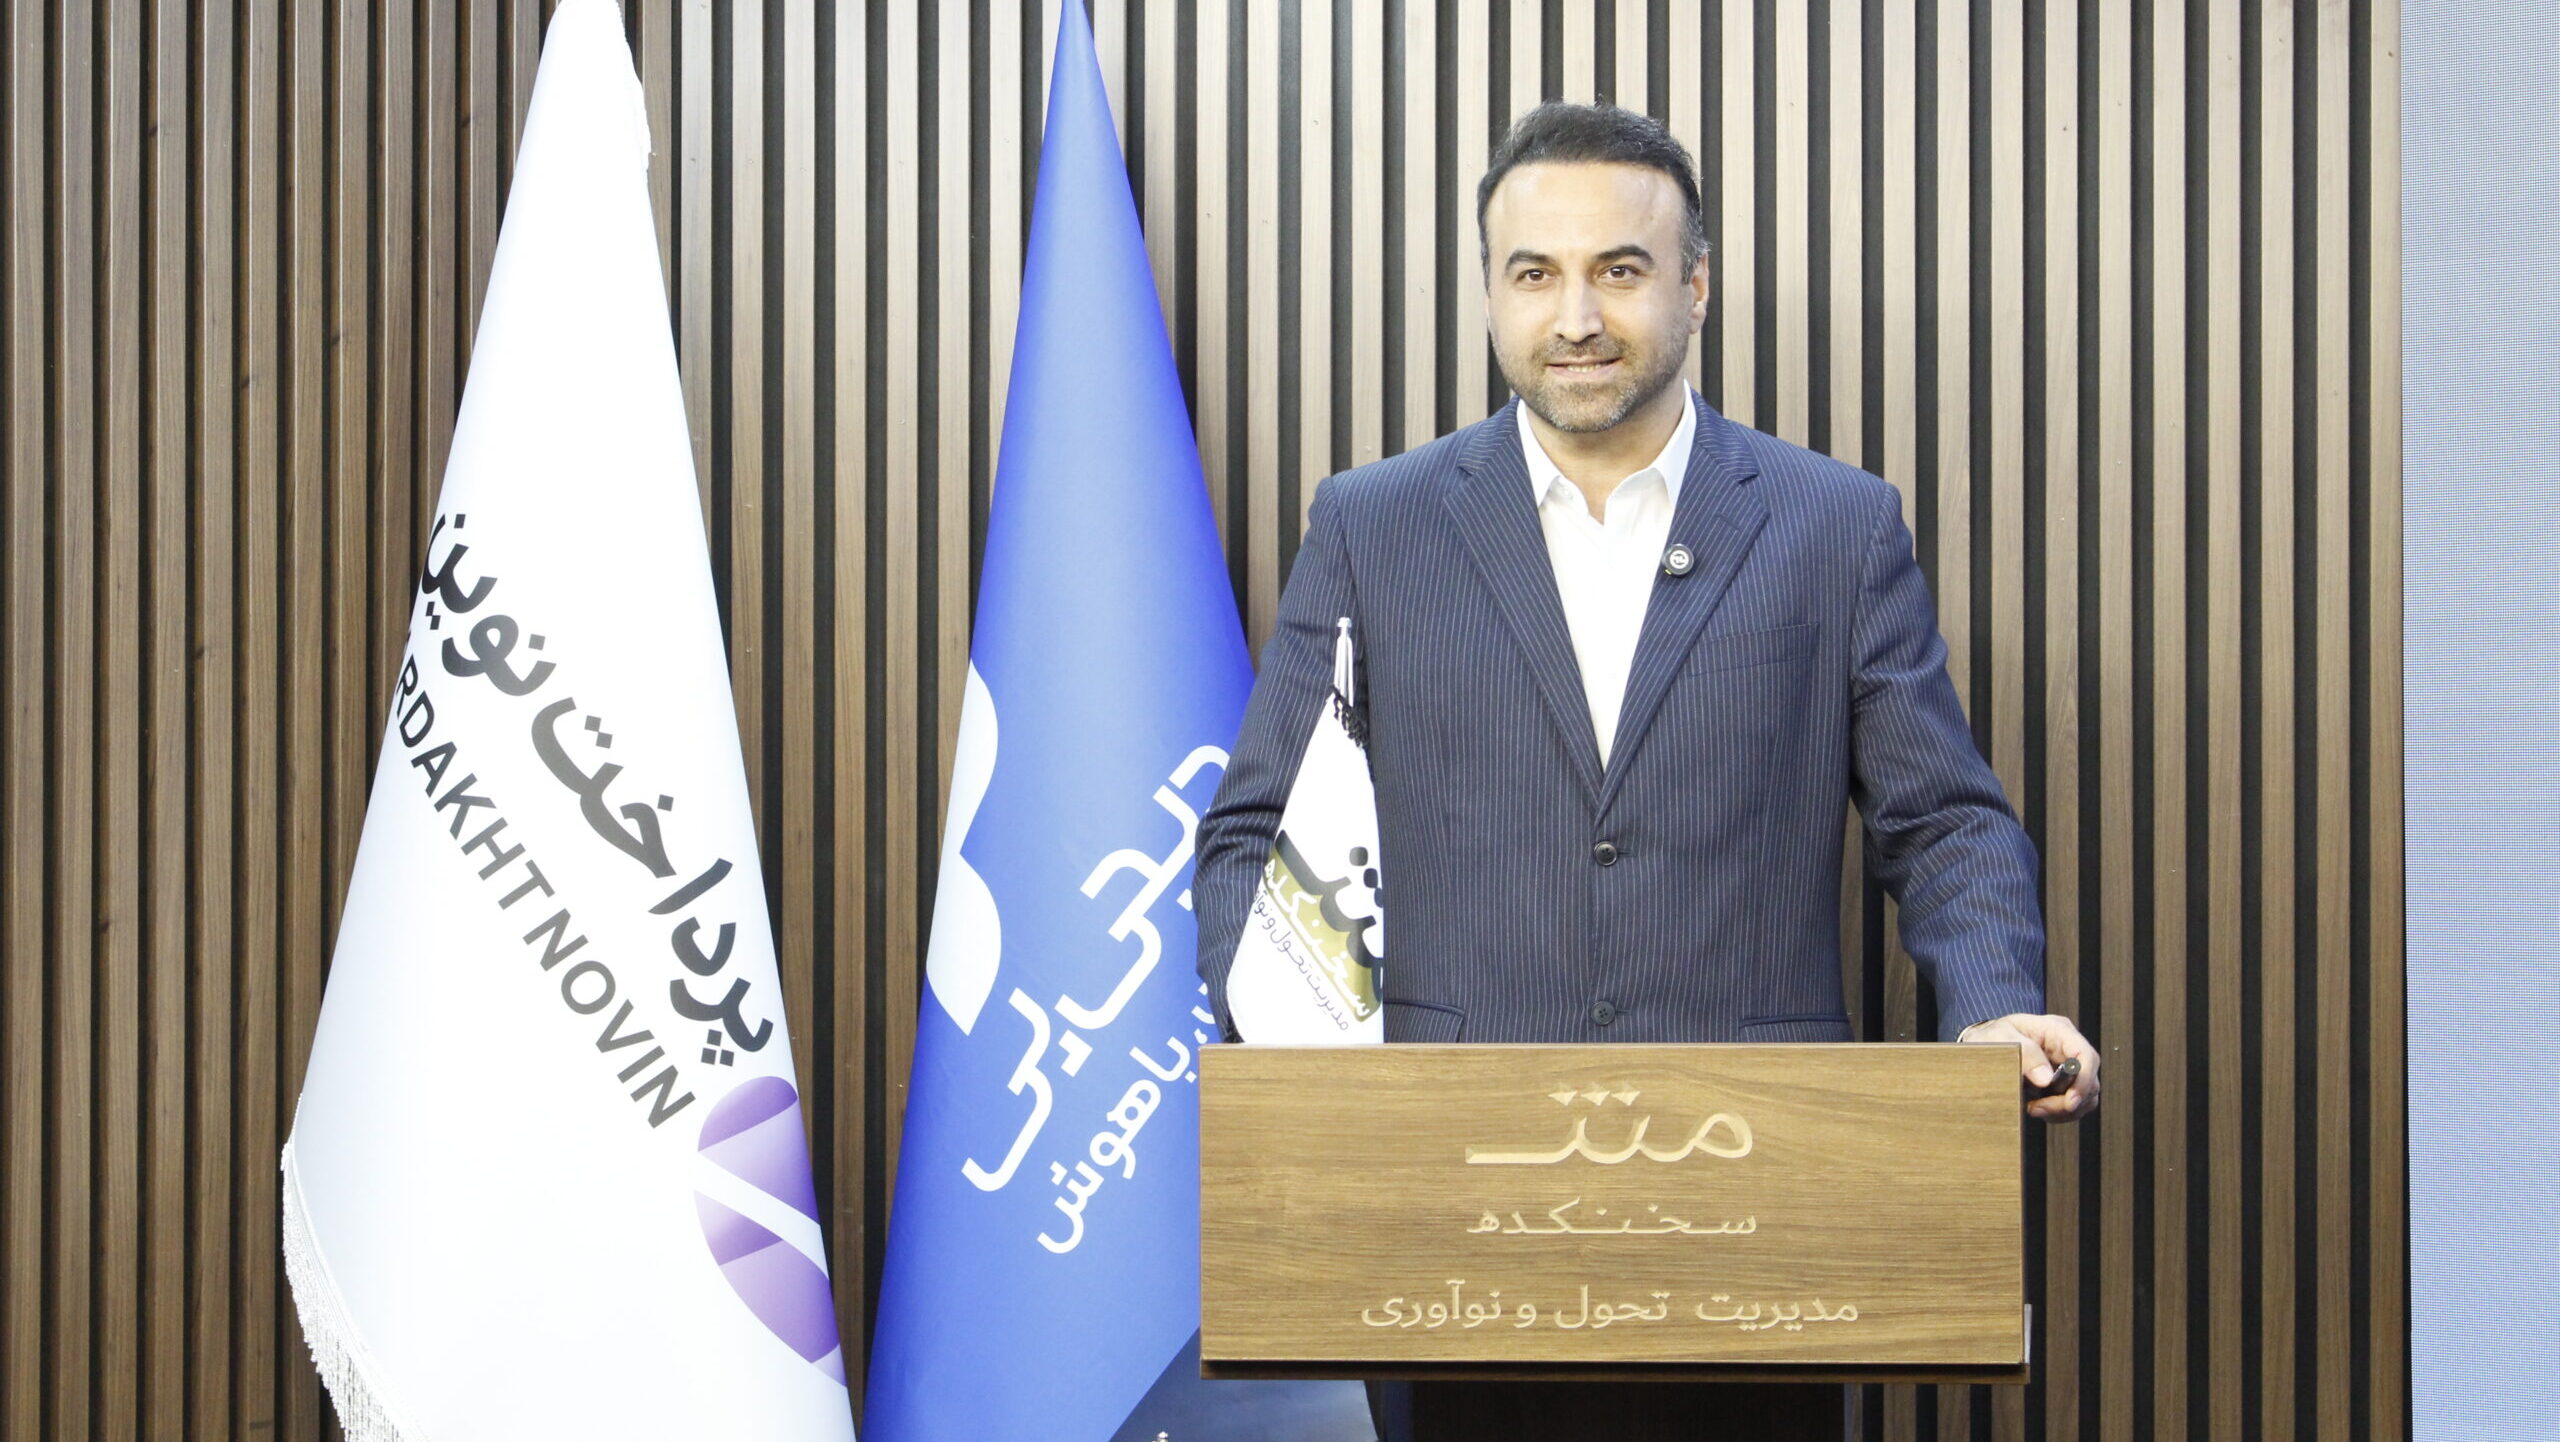
محمد عالیشاهی، مدیر داده و تحلیل شرکت الگوریتم، در استودیو سخنکده متن درباره چالشهای استفاده از هوش مصنوعی و تحلیل داده در بانکها گفت: نبود معماری جامع داده، ضعف کیفیت داده، دادههای نامتوازن و کمبود دادههای تاریخی از مهمترین موانع اجرای موفق پروژههای تحلیل داده در سازمانهای بزرگ هستند.
معماری داده؛ پیشنیاز اجرای پروژههای هوش مصنوعی
به گفته عالیشاهی، اجرای پروژههای هوش مصنوعی با ایجاد یک سرور، تولید فایلهای CSV و ورود داده به مدل، در محیطهای بزرگ و بانکی پاسخگو نیست. او تأکید کرد که پیش از اجرای پروژههای تحلیل داده باید زیرساختهایی مانند دریاچه داده و معماری مناسب داده ایجاد شود.
وی همچنین دادههای خارج از سامانههای بانکی، از جمله اطلاعات صورتحساب شرکتها، دادههای بازار سرمایه و شاخصهای اقتصادی مانند تورم را برای تحلیل اعتبار مشتریان مهم دانست و بر ضرورت استفاده از دادههای معتبر و قابل استناد تأکید کرد.
استفاده از سه مدل برای اعتبارسنجی مشتریان
مدیر داده و تحلیل شرکت الگوریتم با اشاره به اجرای یک پروژه اعتبارسنجی گفت: در این پروژه، پس از بررسی و حذف شاخصهای کماثر، تعداد ویژگیهای مورد استفاده از حدود ۵۰۰ شاخص به ۱۱۸ شاخص مؤثر کاهش یافت.
به گفته او، در ادامه سه مدل رگرسیون لجستیک، جنگل تصادفی و ایکسجیبوست برای ارزیابی و پیشبینی رفتار اعتباری مشتریان به کار گرفته شد. همچنین مشتریان به سه گروه شخصی، شرکتی و تجاری تقسیم شدند تا مدل متناسب با رفتار هر گروه آموزش داده شود.
کاهش ۹۹ درصدی زمان بررسی پروندهها
عالیشاهی اعلام کرد که با اجرای این مدل، زمان بررسی پروندههای اعتباری از سه تا پنج روز کاری به کمتر از پنج دقیقه رسیده است؛ به این ترتیب، زمان بررسی بیش از ۹۹ درصد کاهش یافته است.
او افزود: دقت شناسایی مشتریان بدحساب نیز نسبت به روشهای سنتی افزایش یافته و میزان شناسایی این گروه از حدود ۳۰ درصد به ۵۹ درصد رسیده است. همچنین استفاده از مدلهای هوش مصنوعی موجب کاهش خطای انسانی و افزایش سرعت و دقت تصمیمگیری شده است.
افزایش ظرفیت بررسی پروندهها
به گفته مدیر داده و تحلیل شرکت الگوریتم، در روش سنتی هر کاربر در بهترین حالت روزانه حدود ۲۰ پرونده را بررسی میکرد؛ اما در روش جدید، این ظرفیت به دستکم هزار پرونده در روز رسیده و با استفاده از سرویسهای API امکان بررسی دهها هزار پرونده نیز وجود دارد.